

文/VR陀螺 小鱼
2026年,行业的目光再次齐聚AI大模型。
大模型也不负众望,几乎以“周”为单位持续更新。从文字,到图像、视频等二维多模态,再到更为复杂的三维空间,模型能力边界不断向外延伸,一次次刷新人们对生成式AI的想象。
回看这一年的升级迭代中,会发现有一个领域频繁地出现在各大AI模型能力榜单中,成为了大模型技术升级不可忽视的关键词——3D。
一直以来,3D都被公认为是多模态生成领域里的「硬骨头」,相比于图像、视频等二维模态的生成,3D除了要掌握大模型的推理与生成能力,还得要熟练处理复杂的几何结构、空间关系和多视角一致性等基础,倘若要在虚拟世界实现实时交互,技术难度还会再上一个台阶。
但也是因如此,3D展露的能力与更加符合未来物理AI世界的特质,更有可能成为连接数字AI与物理AI的一张门票。这或许也是2026年,各大模型厂商不愿错过3D的真正原因。
眼下,AI大模型推动着3D技术加速演进,3D也让AI突破更多的想象,两者的融合,正为XR产业打开了新的发展空间。而这场“双向奔赴”的背后,离不开一批长期扎根AI 3D、XR硬件与世界模型领域的企业和团队。他们对技术突破与应用创新的持续探索,同样值得被更多人看见。
由VR陀螺、游戏陀螺联合主办的2026年第十一届金陀螺奖现已正式启动。 本届评选特别设有「年度最佳AI 3D应用」,以及「年度最佳XR技术创新」「年度最佳VR/MR硬件」等多个奖项,聚焦AI与3D深度融合带来的技术突破与应用创新。诚邀相关企业及开发团队积极报名,让更多优秀的产品与创新成果获得行业关注,共同见证产业新突破。
大模型扎堆“造物”,3D资产越来越「可用」
2026年,专业AI 3D模型的迭代速度明显加快。从各大厂商的升级方向来看,AI生成的3D模型正变得越来越「可用」了。
要知道,以往AI生成的3D通常存在网格布线混乱、几何结构变形、材质贴图失真等问题,即便静态展示时效果不错,一旦需要进行角色绑定、动画制作,或导入游戏引擎,很有可能就会暴雷,后续还得靠美术人员重新调整,甚至推倒重来。
针对这些卡点,今年模型厂商在几何精度、材质和模型可编辑性上,作出了很多的调整。
图源:腾讯混元
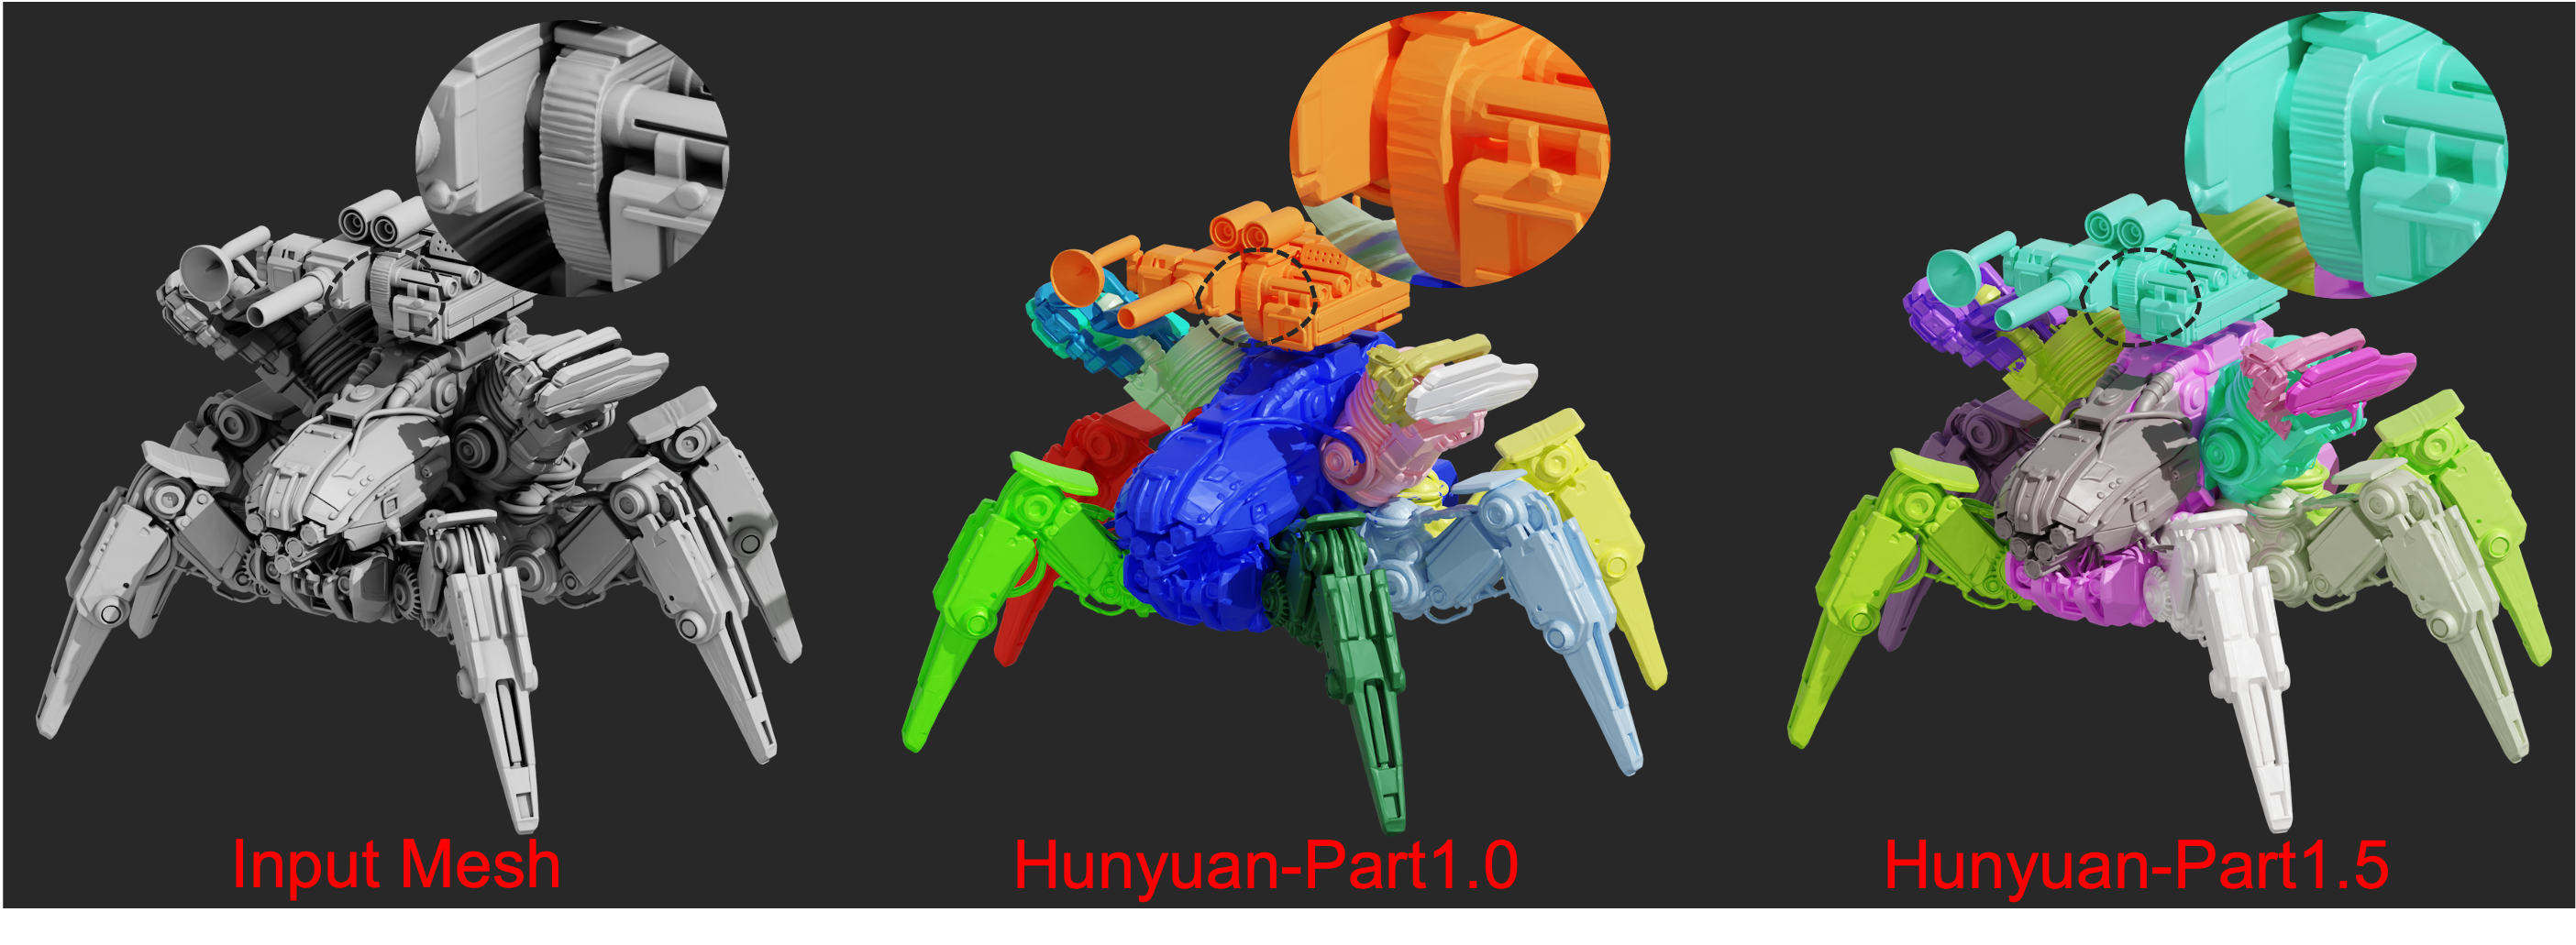
比如,年初腾讯混元推出的3D3.1就在提升几何与纹理质量的同时,将多视角输入拓展至八视图,引入PartGen 1.5,提供了更强的拆分细节保留能力,改善了单图生成容易出现的背面结构失真问题。字节跳动在4月推出的Seed3D 2.0,着重改善了锐利边缘、薄壁结构等复杂几何细节,引入了统一的PBR材质生成方案,让模型在不同光照下呈现更合理的材质效果。到了9月,VAST推出的Tripo P2.0,可以支持原生四边面拓扑生成,并允许Mesh Edit局部修改模型,让模型的布线更加规整的同时,又方便后续编辑、骨骼绑定和动画制作。
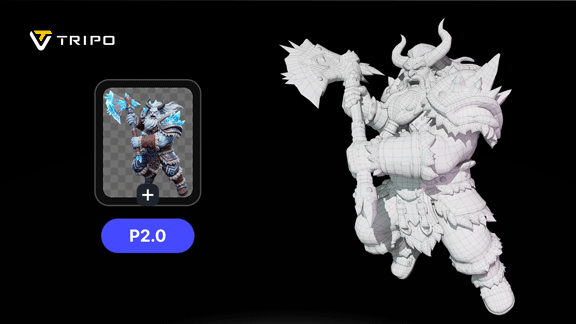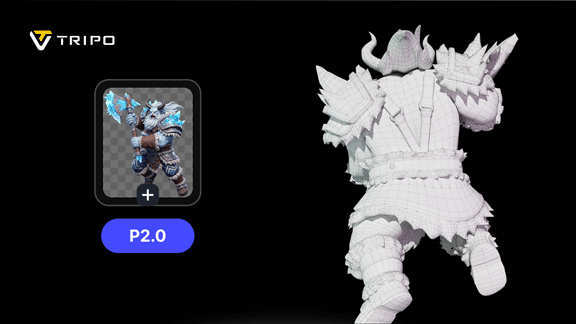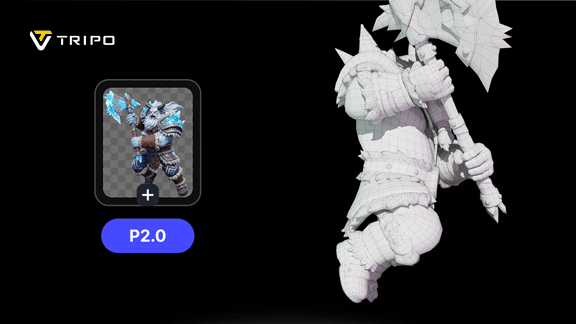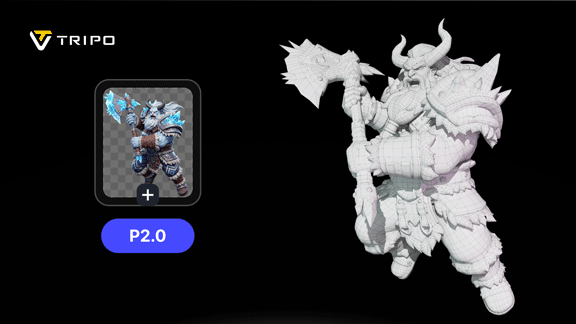
图源:VAST
可见,一系列3D模型的改进,正在补齐专业生产的短板。而一批AI Agent的涌入,也正将工作流程变得高效便捷,大幅降低3D创作的门槛。
图源:Meshy
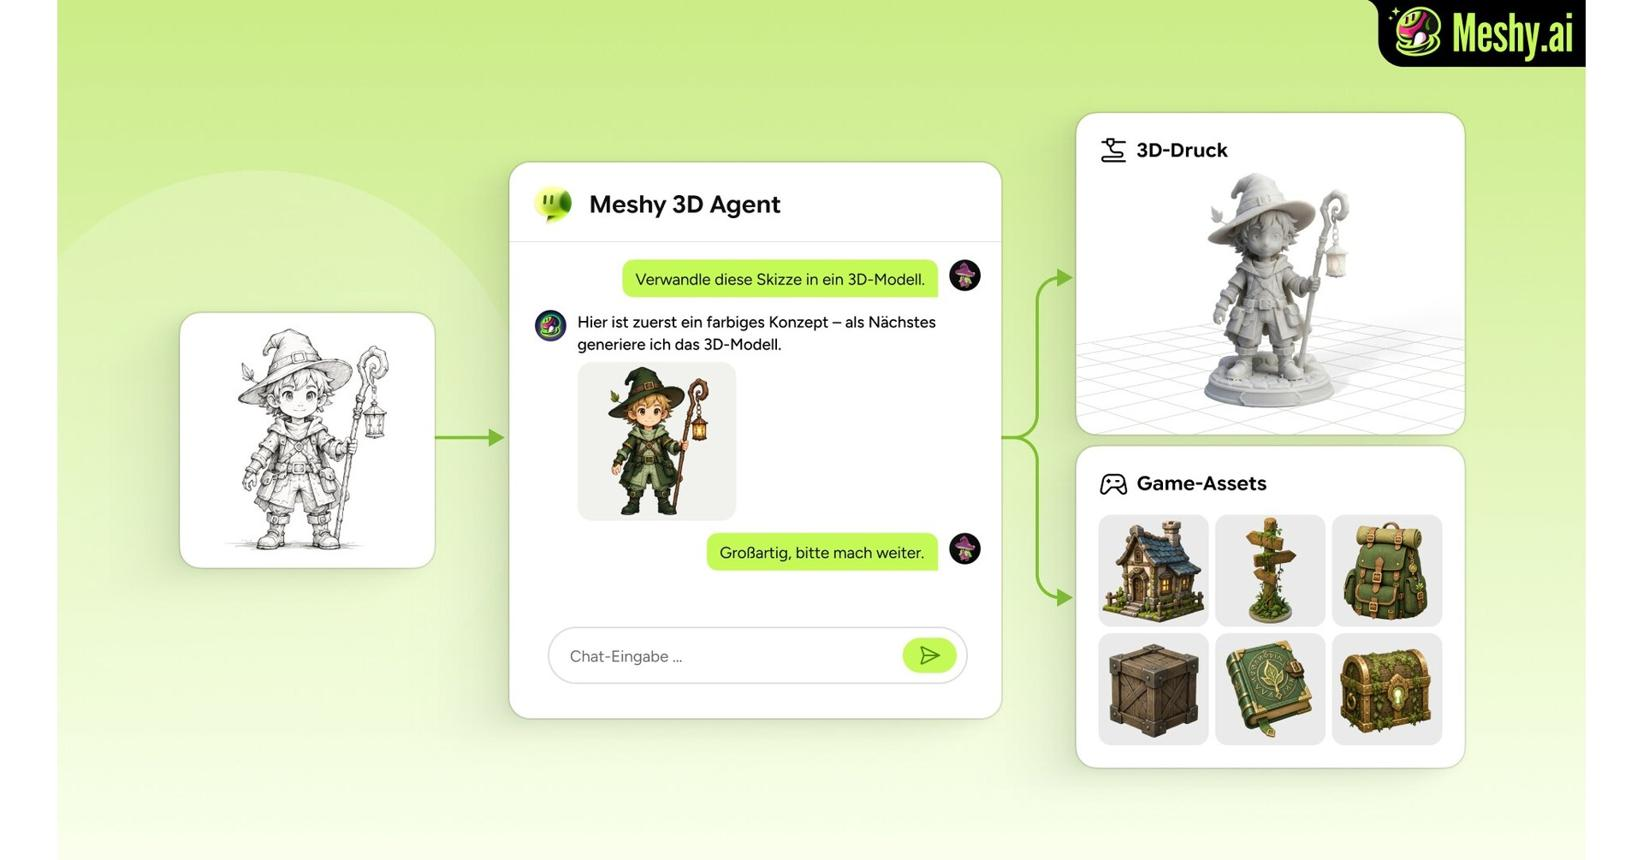
比如今年6月,Meshy推出的3D Agent,把创意讨论、概念图生成、三维建模乃至最终导出,一口气整合成了完整的工作流。只需需描述想法,就可以让AI生成想要的3D资产,省去了反复切换工具、调整参数等麻烦。
但「降门槛」这件事,显然不是专业模型厂商的“独角戏”。随着3D技术的重要性日渐凸显,就连过去以推理、编程见长的通用大模型,也忍不住掺上一脚。
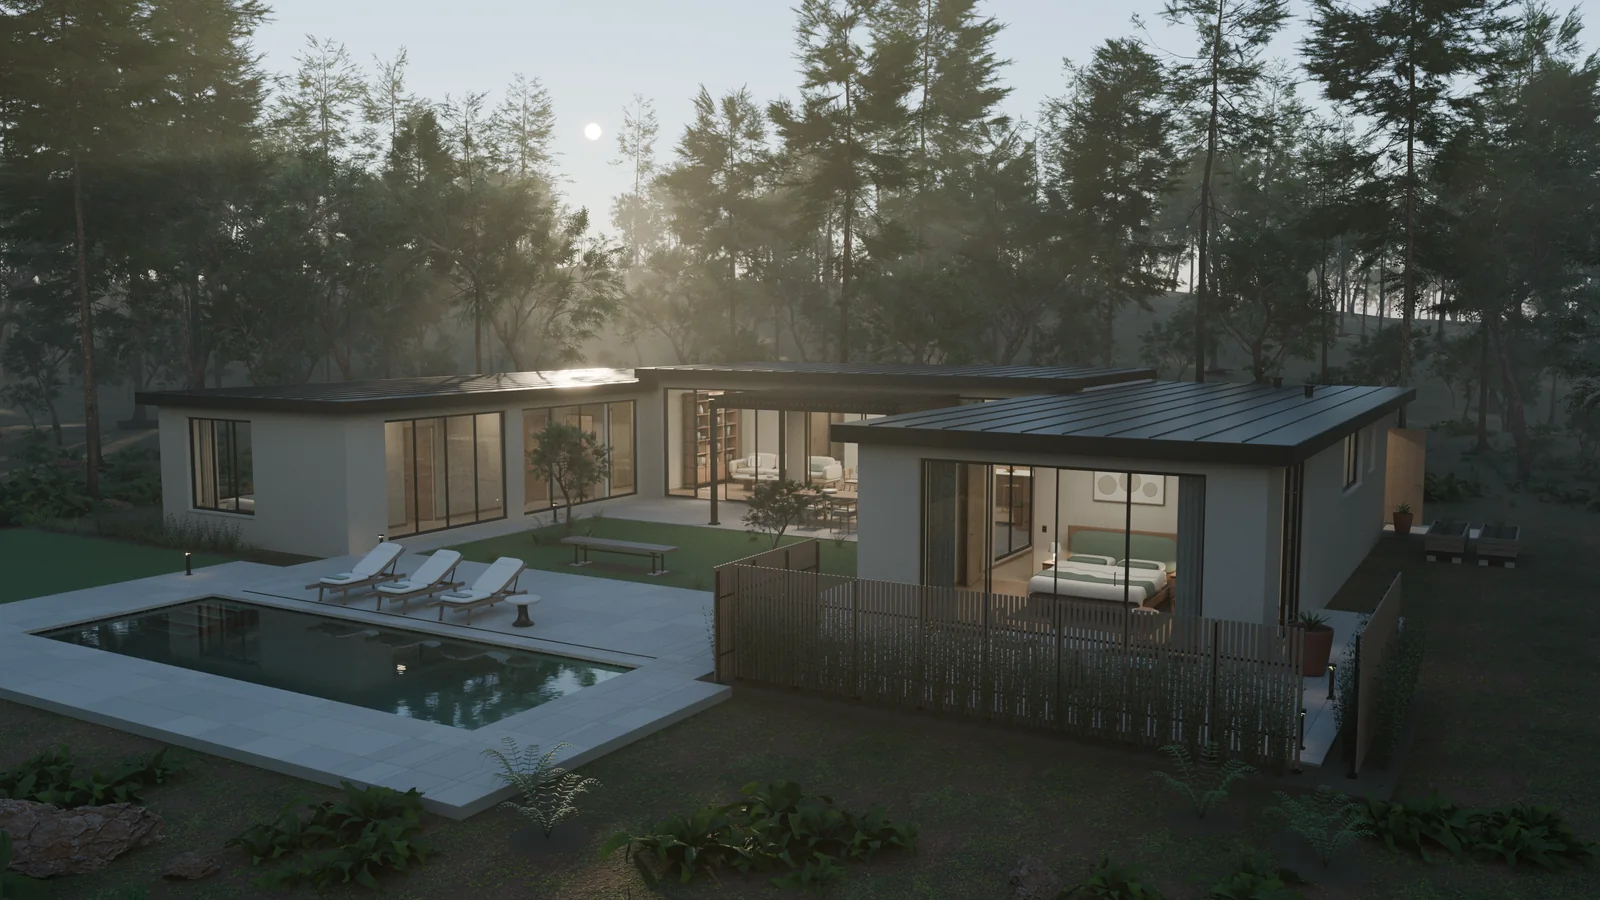
图源:OpenAI
尤其是今年9月,OpenAI发布的GPT-6 Astra,直接在开发者群体中掀起了一波「AI 3D创作热潮」。有人让它调用Blender,上演“平地起高楼”;有人让它还原更为立体的三维结构,让复杂的机械图纸“跃然屏上”。一瞬间,「人人皆是3D造物主」有了更为具体的实象。
https://res.vrtuoluo.cn/production/admin/uploads/20261118/1794967837320Anthropic.mp4
图源:Anthropic
还有前不久,Anthropic推出的Claude Fable 5.2与Mythos 5.2,甚至能把「造物」的触角伸向实体设计中。在官方公布的视频里,Claude已经能轻而易举控制机器人拧魔方、开瓶盖、绘制画像。
由此,AI与3D也就形成了一种密切的功能互补关系。一边,专业3D模型在不断提升资产质量,解决“能不能用”的问题;另一边,通用大模型与AI Agent在接手繁琐的制作流程,降低“会不会用”的门槛。两条路线起头并进,让3D创作逐渐从技术尝鲜走向更广泛的生产应用。
从「造物」到「造世界」,AI 3D“活”了起来
对于构建一整个3D世界而言,造出几个精美、可用的三维资产,充其量只是备齐了「砖瓦」。
毕竟,能造出一栋房子,与让人真正走进房子、推开房门、自由探索,完全就是两回事。这不仅考验模型生成三维场景的能力,还要求其理解复杂的空间关系、保持场景的一致性,甚至预测环境如何随着人的操作发生变化。
业内愿意把这类模型称之为「世界模型」,而今年也能看到很多科技公司都在竞相涌入这个方向,把目光从单个三维物体,投向更加完整、复杂的虚拟世界。

图源:腾讯混元
4月16日,腾讯推出HY-World 2.0,将3D生成从单个物体拓展至完整空间,不仅支持自由漫游,还能输出可复用的三维资产,让AI生成的世界不仅能看、能逛,还能用于游戏、影视等专业创作。
同一天,阿里推出HappyOyster,进一步玩起了「实时造世界」。用户不仅能够在AI生成的环境中自由漫游,还能通过自然语言改变镜头、角色乃至剧情走向,让虚拟世界跟着自己的指令不断变化。
到了下半年,这场「造世界」的竞赛愈发热闹。
https://res.vrtuoluo.cn/production/admin/uploads/20261118/1794967904080world+labs.mp4
图源:World Labs
9月,李飞飞创办的World Labs推出世界模型Atlas,将文字、图像、视频与3D信息纳入统一的空间上下文。不仅能够尝试补全镜头之外的空间、生成新的观察视角,还能进一步重建可探索的三维场景。两个月后,它又拿出了Frameboy,只需在浏览器中控制方向,就能以最高每秒15帧的速度,像玩游戏一样,在AI实时生成的虚拟环境中四探索。
https://res.vrtuoluo.cn/production/admin/uploads/20261118/1794967943502谷歌.mp4
图源:谷歌
10月底,谷歌发布了Genie 4,用户可以随时改变天气、加入角色,甚至与虚拟人物实时对话,模型可根据用户的操作,持续生成场景变化、人物行为乃至事件的后续发展。
从生成完整的三维场景,到实时探索、动态交互,尽管各家厂商的技术路线不尽相同,但他们都指向同一个趋势:3D虚拟世界,正从过去静态、预先生成的场景,逐渐变成能够随着人的行动持续变化的动态环境。
从屏幕到现实,3D成了AI的「练兵场」
而当这些由AI生成的虚拟世界“动”起来,3D的价值也逐渐拓展到现实里的各行各业。
对于机器人、自动驾驶等需要与物理环境打交道的AI而言,这些三维世界,很有可能会成为一座座可以反复训练、模拟和试错的「数字训练场」。
11月16日,AMD以82亿美元正式收购了World Labs,很大程度就是看中了其3D生成场景在机器人训练、物理仿真和新一代AI计算基础设施中的潜力。要知道,机器人在真实环境中训练,不仅成本高、周期长,还可能因为一次操作失误造成设备损坏。而借助3D与世界模型,机器人便有机会先在虚拟环境里「练好本领」,再到现实世界上岗。
今年,这种「先在虚拟世界练兵,再到真实世界干活」的技术路线,正在加速走向实际应用。10月20日,英伟达推出Cosmos3-H-Dreams,将生成式世界模拟带进了手术场景。模型可以根据手术器械的动作,实时生成相应的腹腔镜画面,模拟组织牵拉、器械移动等变化,为手术机器人研究提供新的虚拟实验环境。
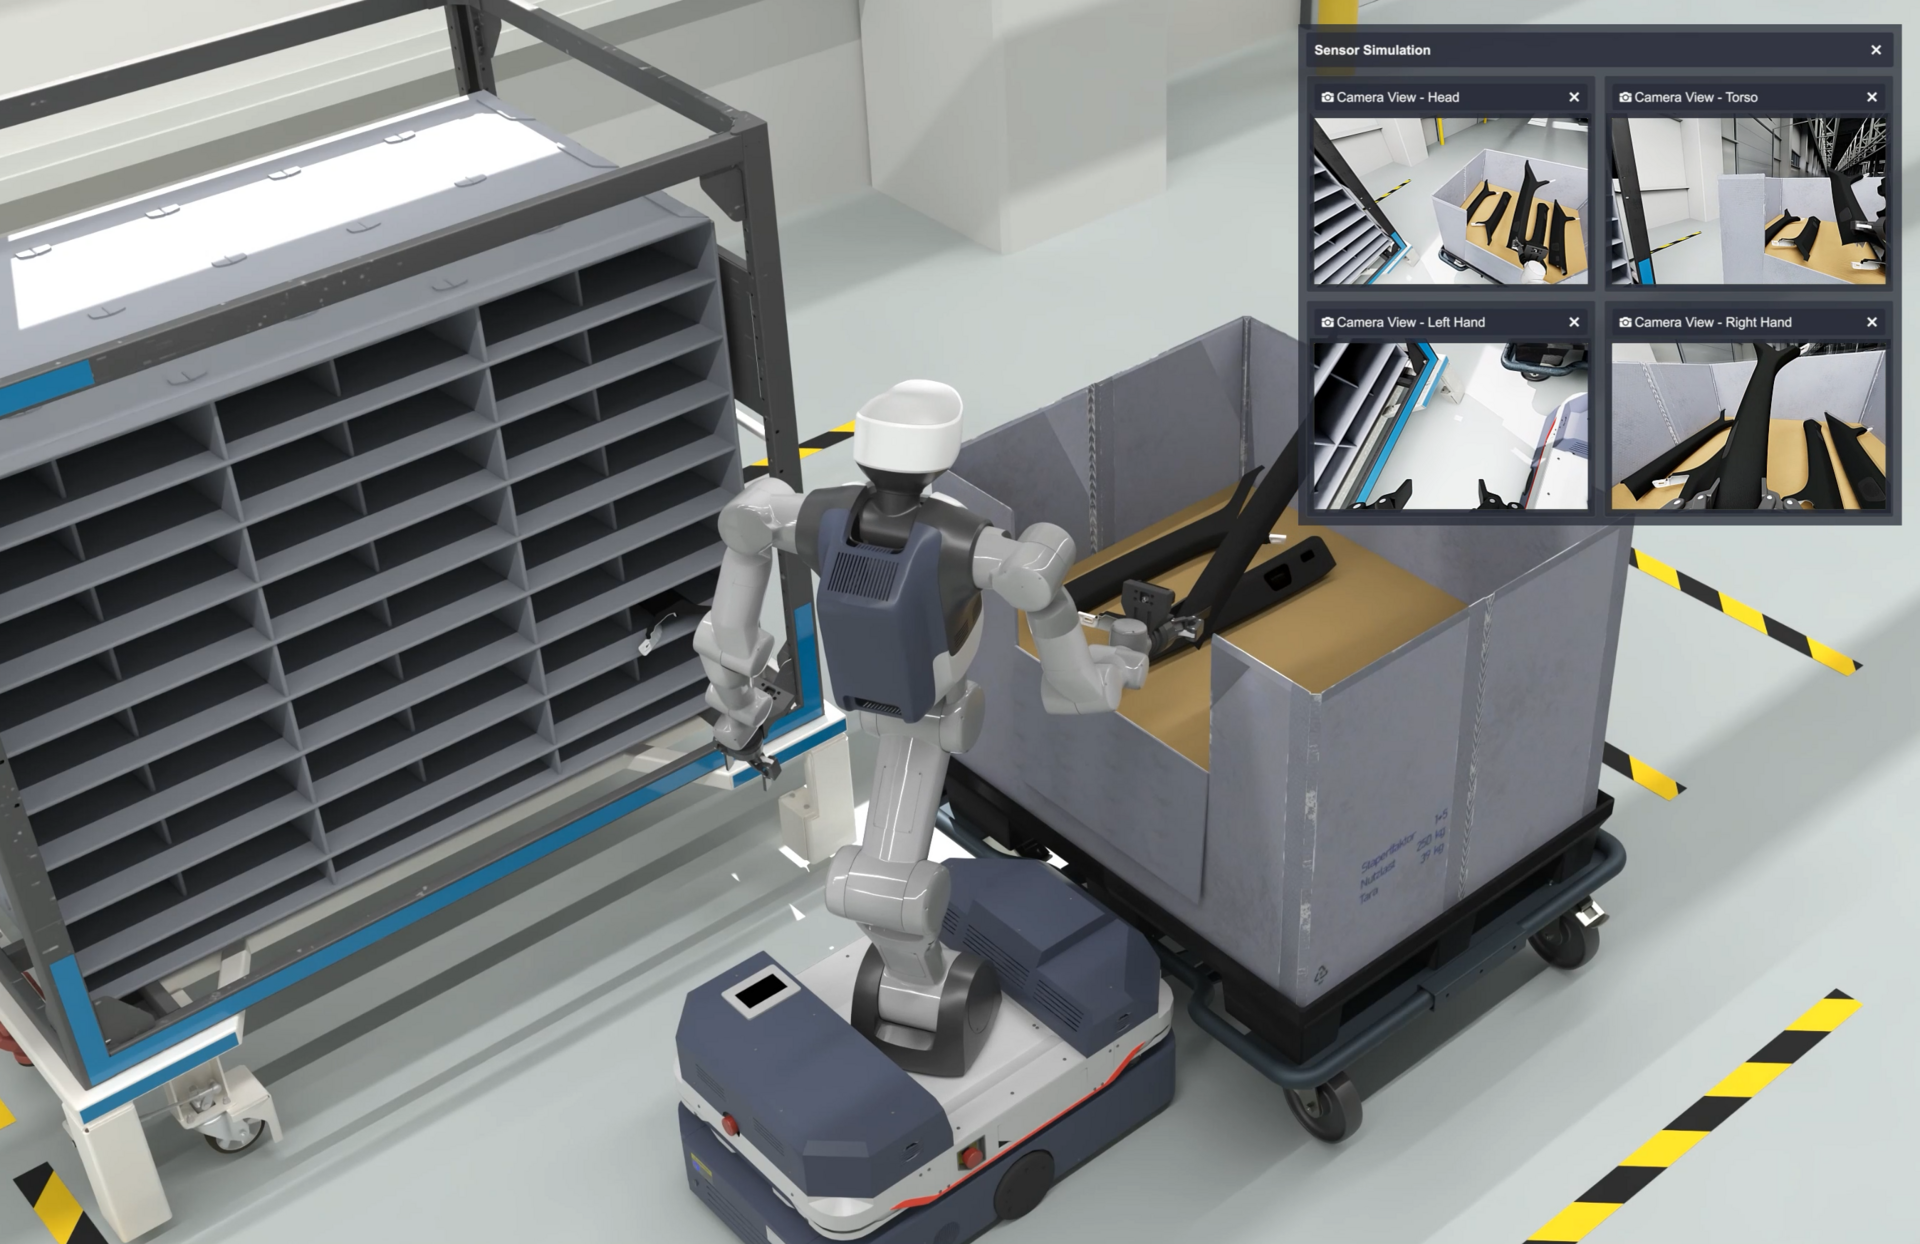
图源:奥迪
甚至连传统汽车工厂,也给机器人搭建了「虚拟练兵场」。10月21日,奥迪联合Agile Robots、达索系统和英伟达,在生产实验室中构建虚拟孪生环境,让移动人形机器人提前演练零部件抓取、搬运和排序等任务,并验证动作可行性、作业节拍与安全性。
简单来说,机器人还没正式进厂,就能先在数字工厂里「试上一班」。
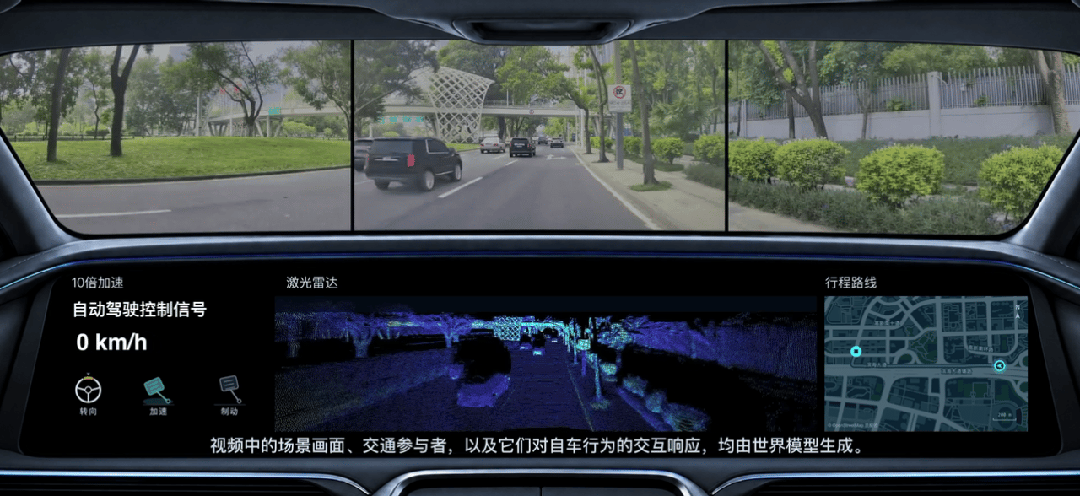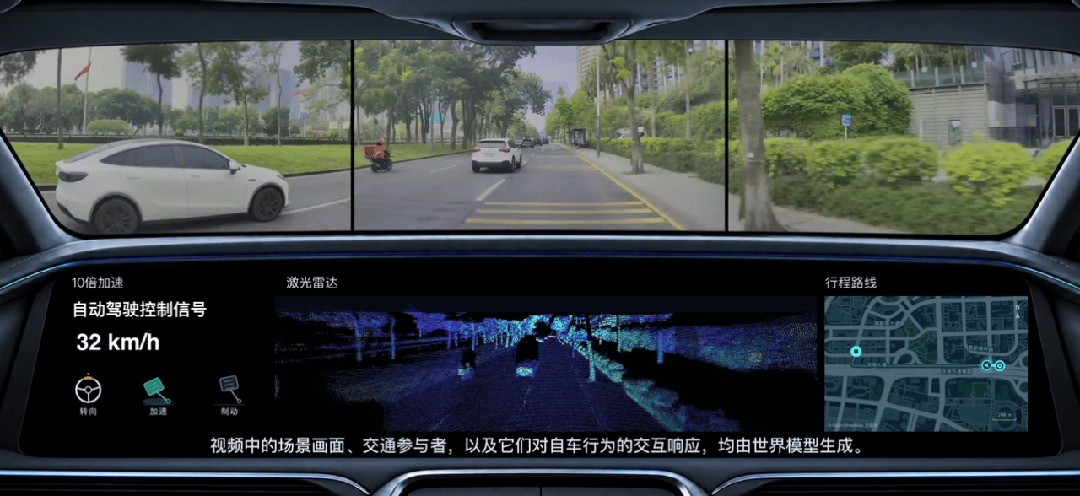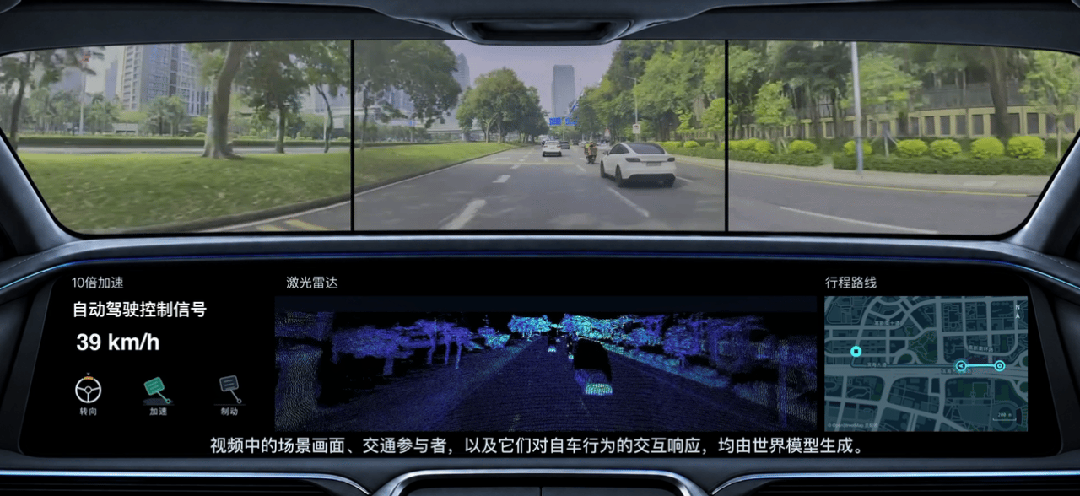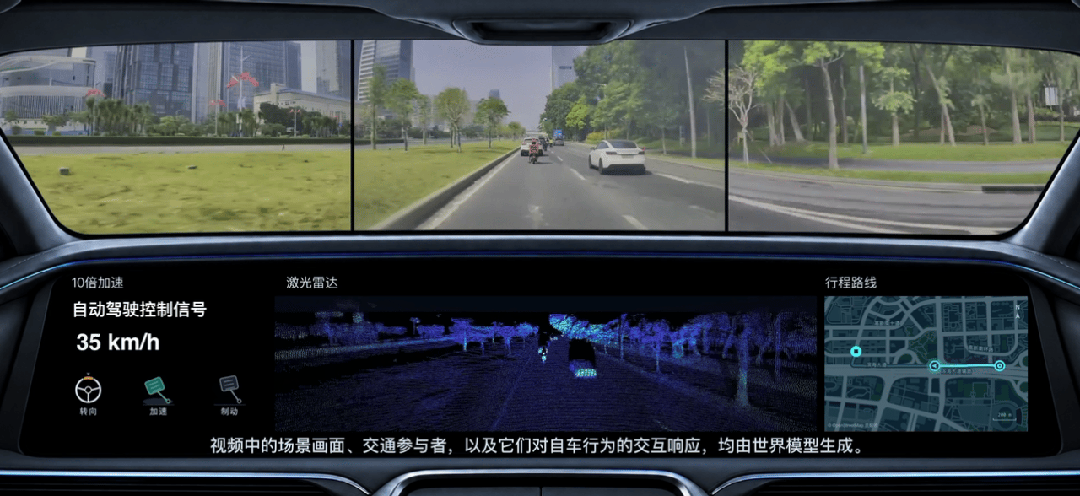
图源:百度
在自动驾驶领域,百度推出的Apollo World,能够模拟复杂道路环境及其动态变化,并实时生成摄像头、激光雷达等多模态数据,每天最多可生成相当于10万公里的模拟驾驶数据。
当然,AI能造出一个看起来逼真的世界,与真正理解这个世界,仍然存在不小的距离。但也正因存在着距离,也倒逼AI模型厂商把3D技术往更深处发展。
可以预见的是,随着3D不断与更多大模型融合,AI也正一步步走出屏幕,向更加广阔的物理世界迈进。